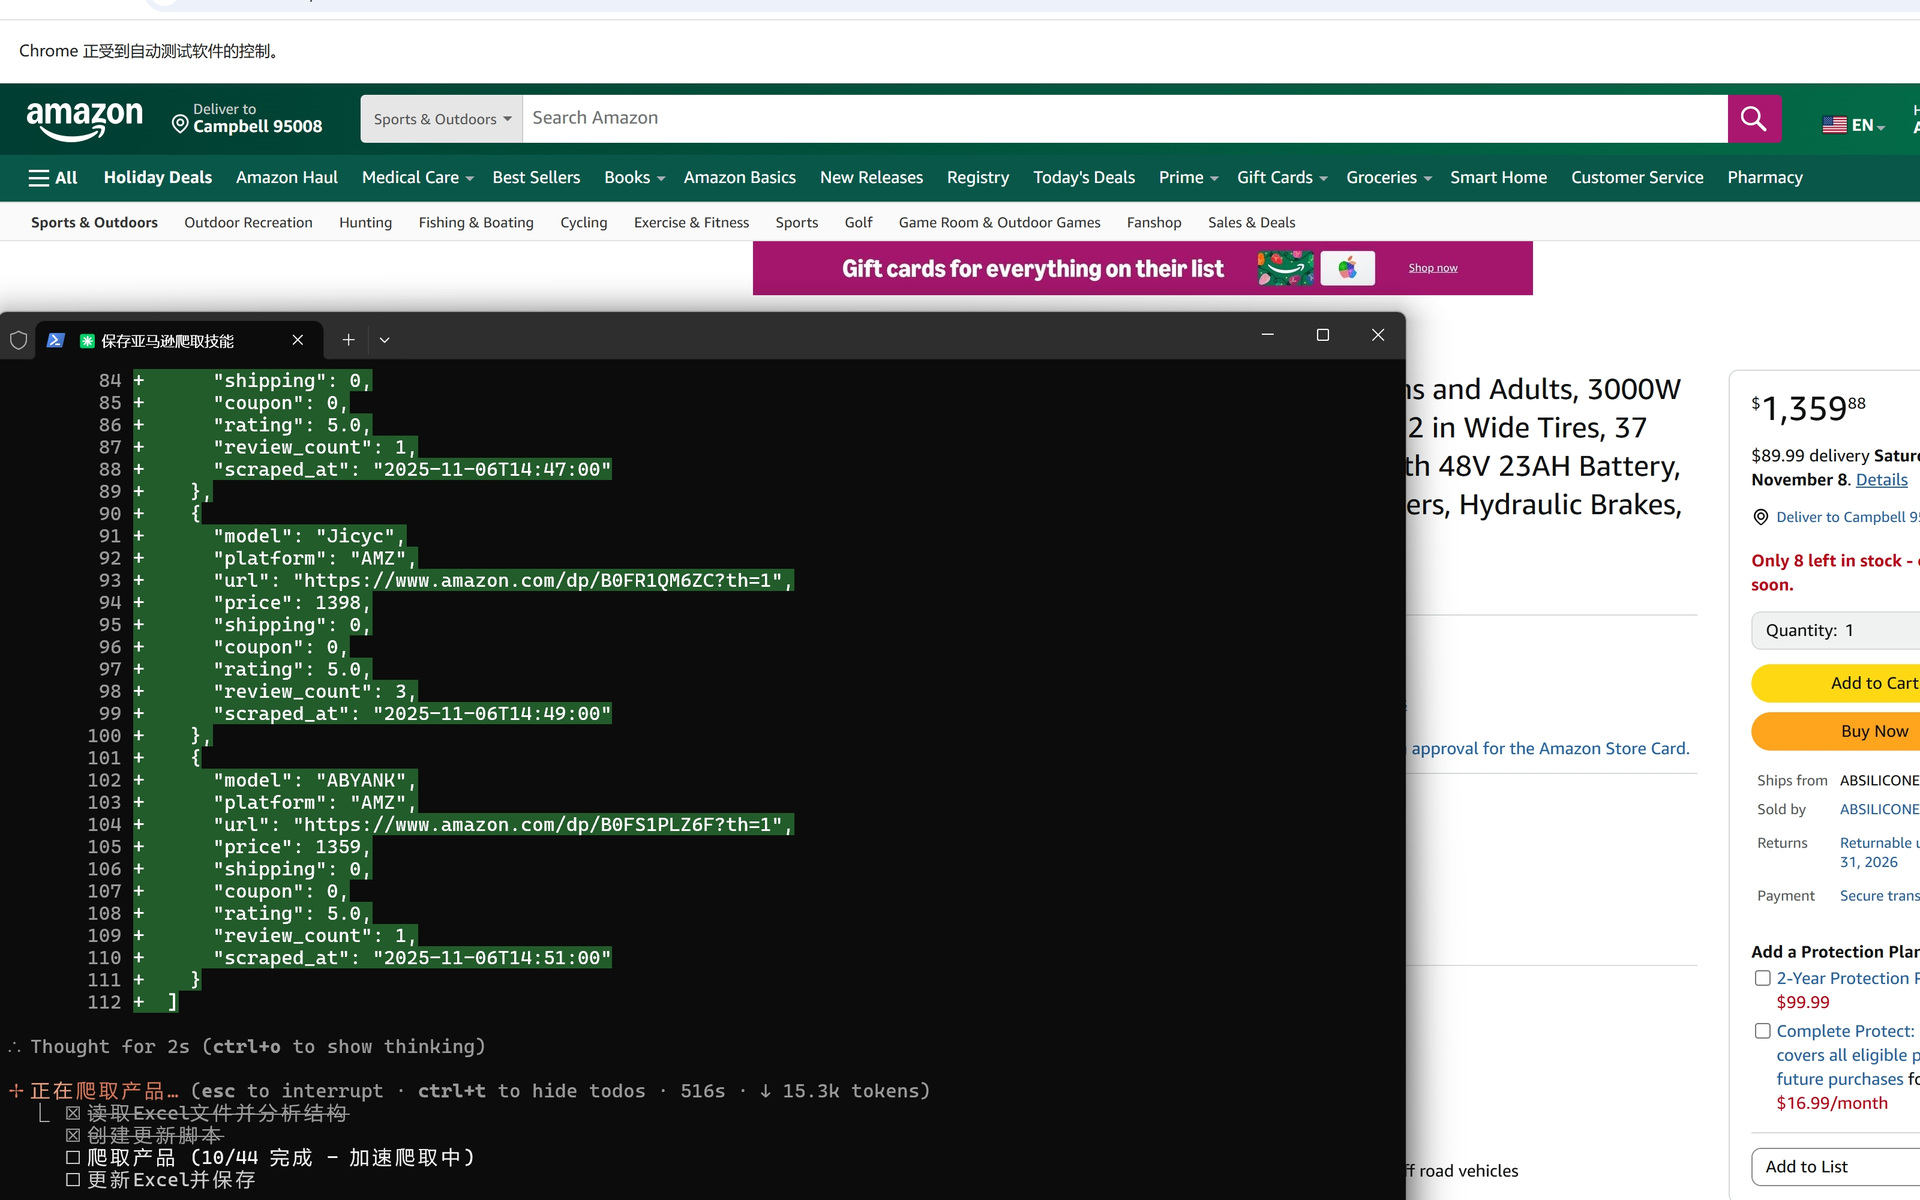
去年 11 月 6 日下午,运营同事发来一张 Excel,叫"旺季待开发竞品监控表"。第一页是总清单,后面五页按系列分:200 MINI BIKE、EDB、Tuttio、125CC-140CC GDB、E MINI BIKE,一共 44 行链接,每行要维护售价、运费、coupon、星级、星级数量,最后一列总售价是个公式。这张表之前是人盯着 Amazon 和 Walmart 的商品页一行一行抄的。
前两天我刚在 C:\diaoY\01 这个目录里用 Claude Code 加 Chrome DevTools MCP 抓过 1688 的搜索列表(那是另一篇)。工具链现成,我就在同一个目录里把这张表丢给它。结果是:从下午三点零七分开始,到四点十九分写回最终文件,46 条数据进了表,Amazon 那边没什么波折,Walmart 的 8 条被"Robot or human?"卡了二十多分钟。写这篇的时候我重新打开那张表核对了一遍,还发现了几处当时没注意到的漏洞,一并写在后面。
先读表,再写脚本
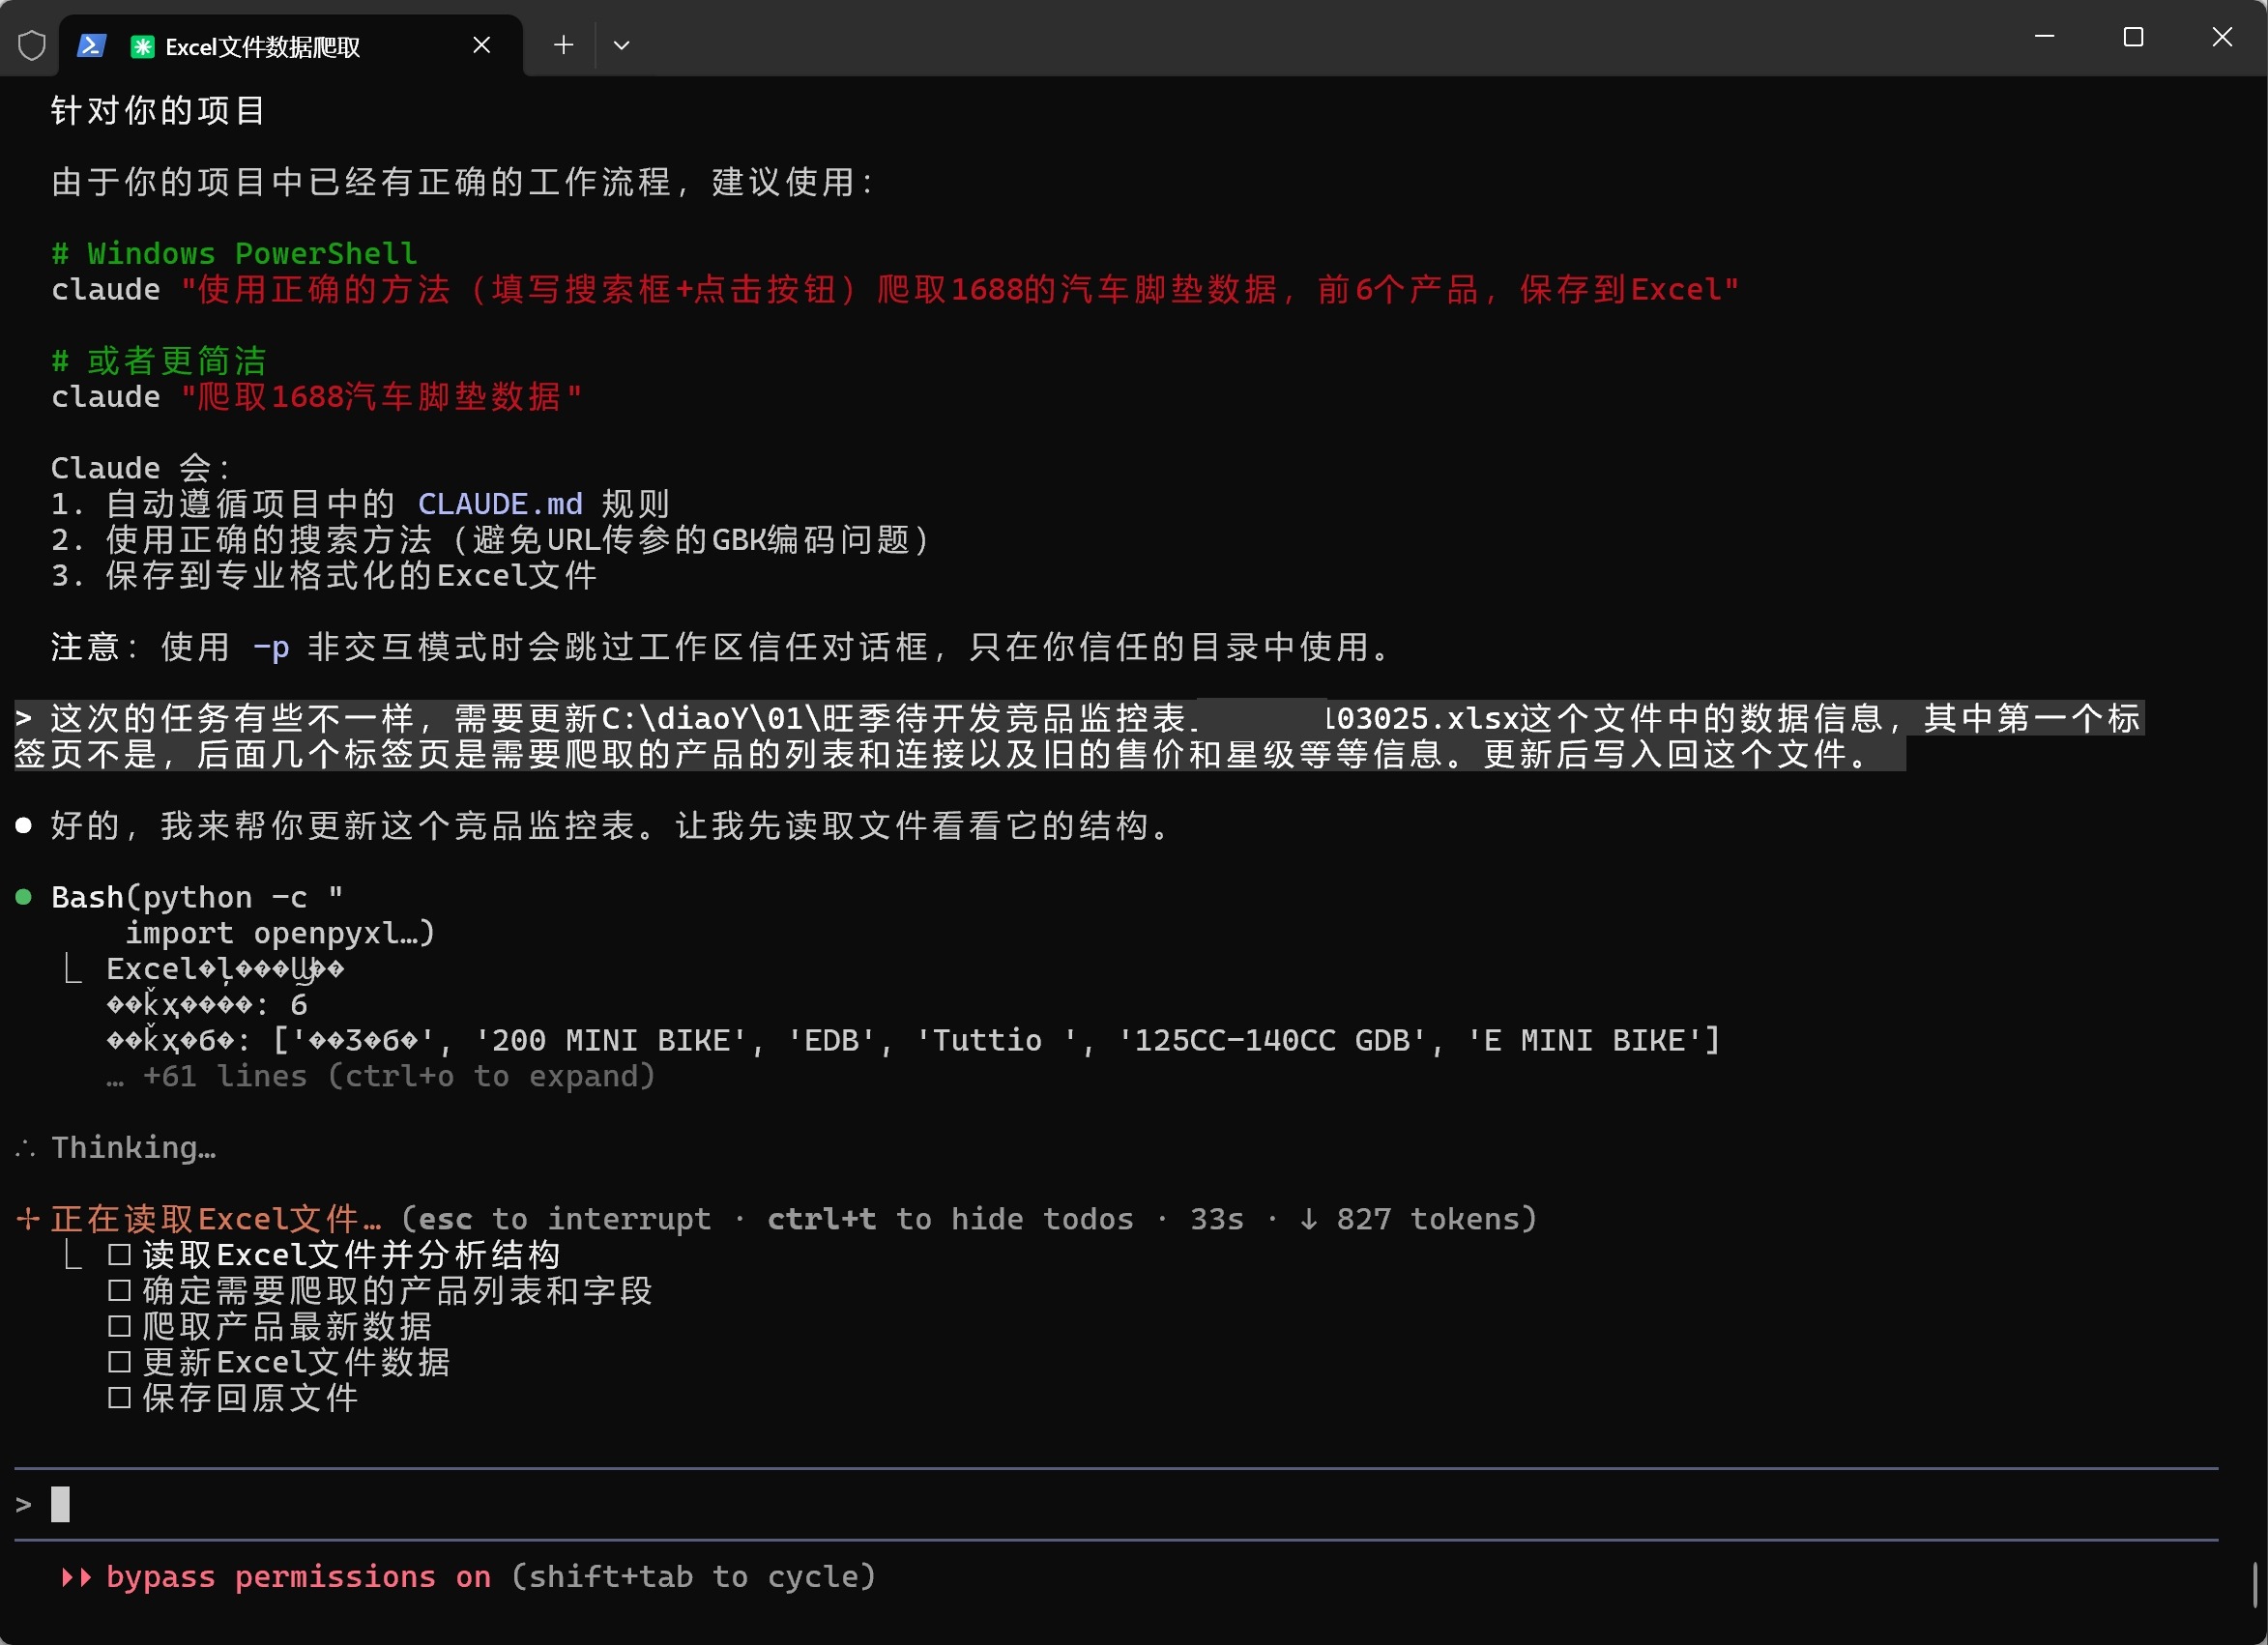
我给它的原话是:这个文件第一个标签页不是,后面几个标签页是需要爬取的产品的列表和链接以及旧的售价和星级等等信息,更新后写入回这个文件。
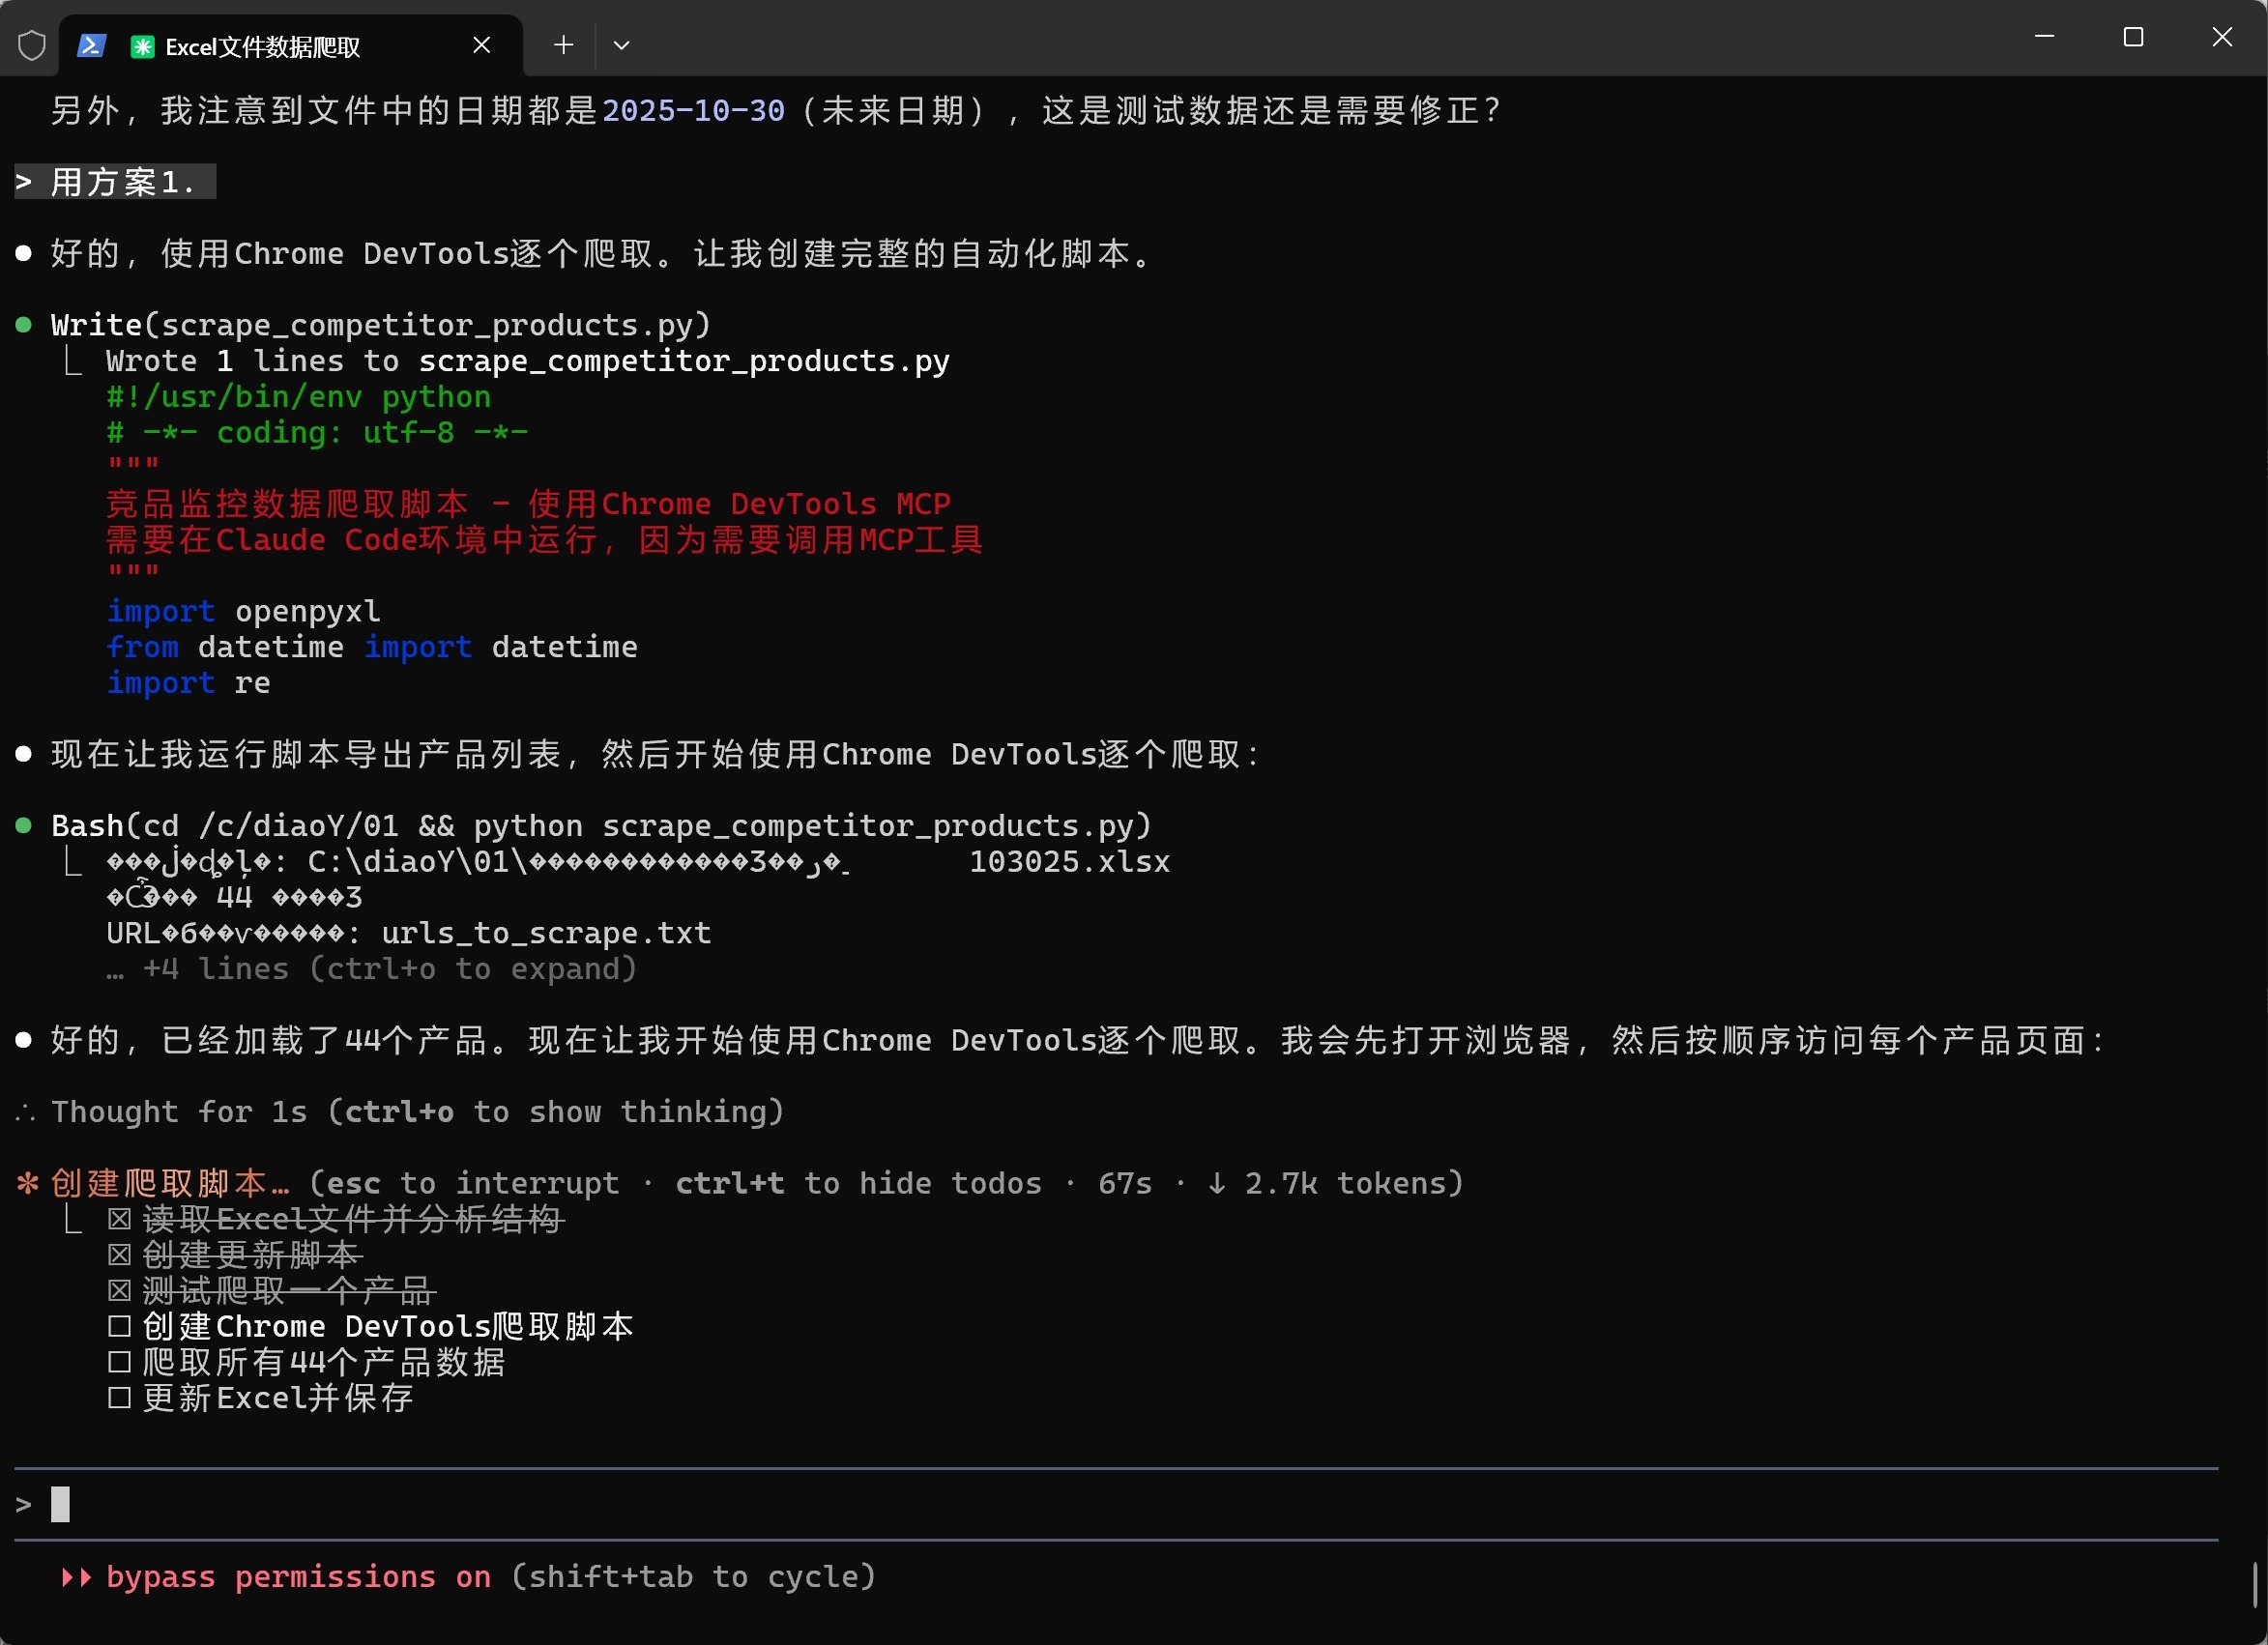
它先用 openpyxl 把工作簿读了一遍,列出 6 个 sheet,顺手指出日期列全是 2025-10-30,问我是不是测试数据。然后给了两个方案,我回了"用方案 1",也就是用 Chrome DevTools 一个页面一个页面打开。
它写了两个脚本。第一个 update_competitor_monitor.py 其实是个壳:里面有解析价格、星级、评论数的正则,有回写 Excel 和建备份的逻辑,但真正抓页面的函数是空的,注释写着"实际实现需要调用 Chrome DevTools"。这是 Claude Code 干活时常见的形态:能在 Python 里做的事放脚本里,需要浏览器的那一步留给 MCP 工具。
第二个 scrape_competitor_products.py 才是主干。它从第二个 sheet 开始逐行读型号、平台、链接、旧售价、旧星级,把 44 条导出成 urls_to_scrape.txt,抓到的结果存进 scraped_data.json,最后按链接把数据对回每一行,先存一份带时间戳的备份再覆盖原表。
真正读页面的是一段 JS
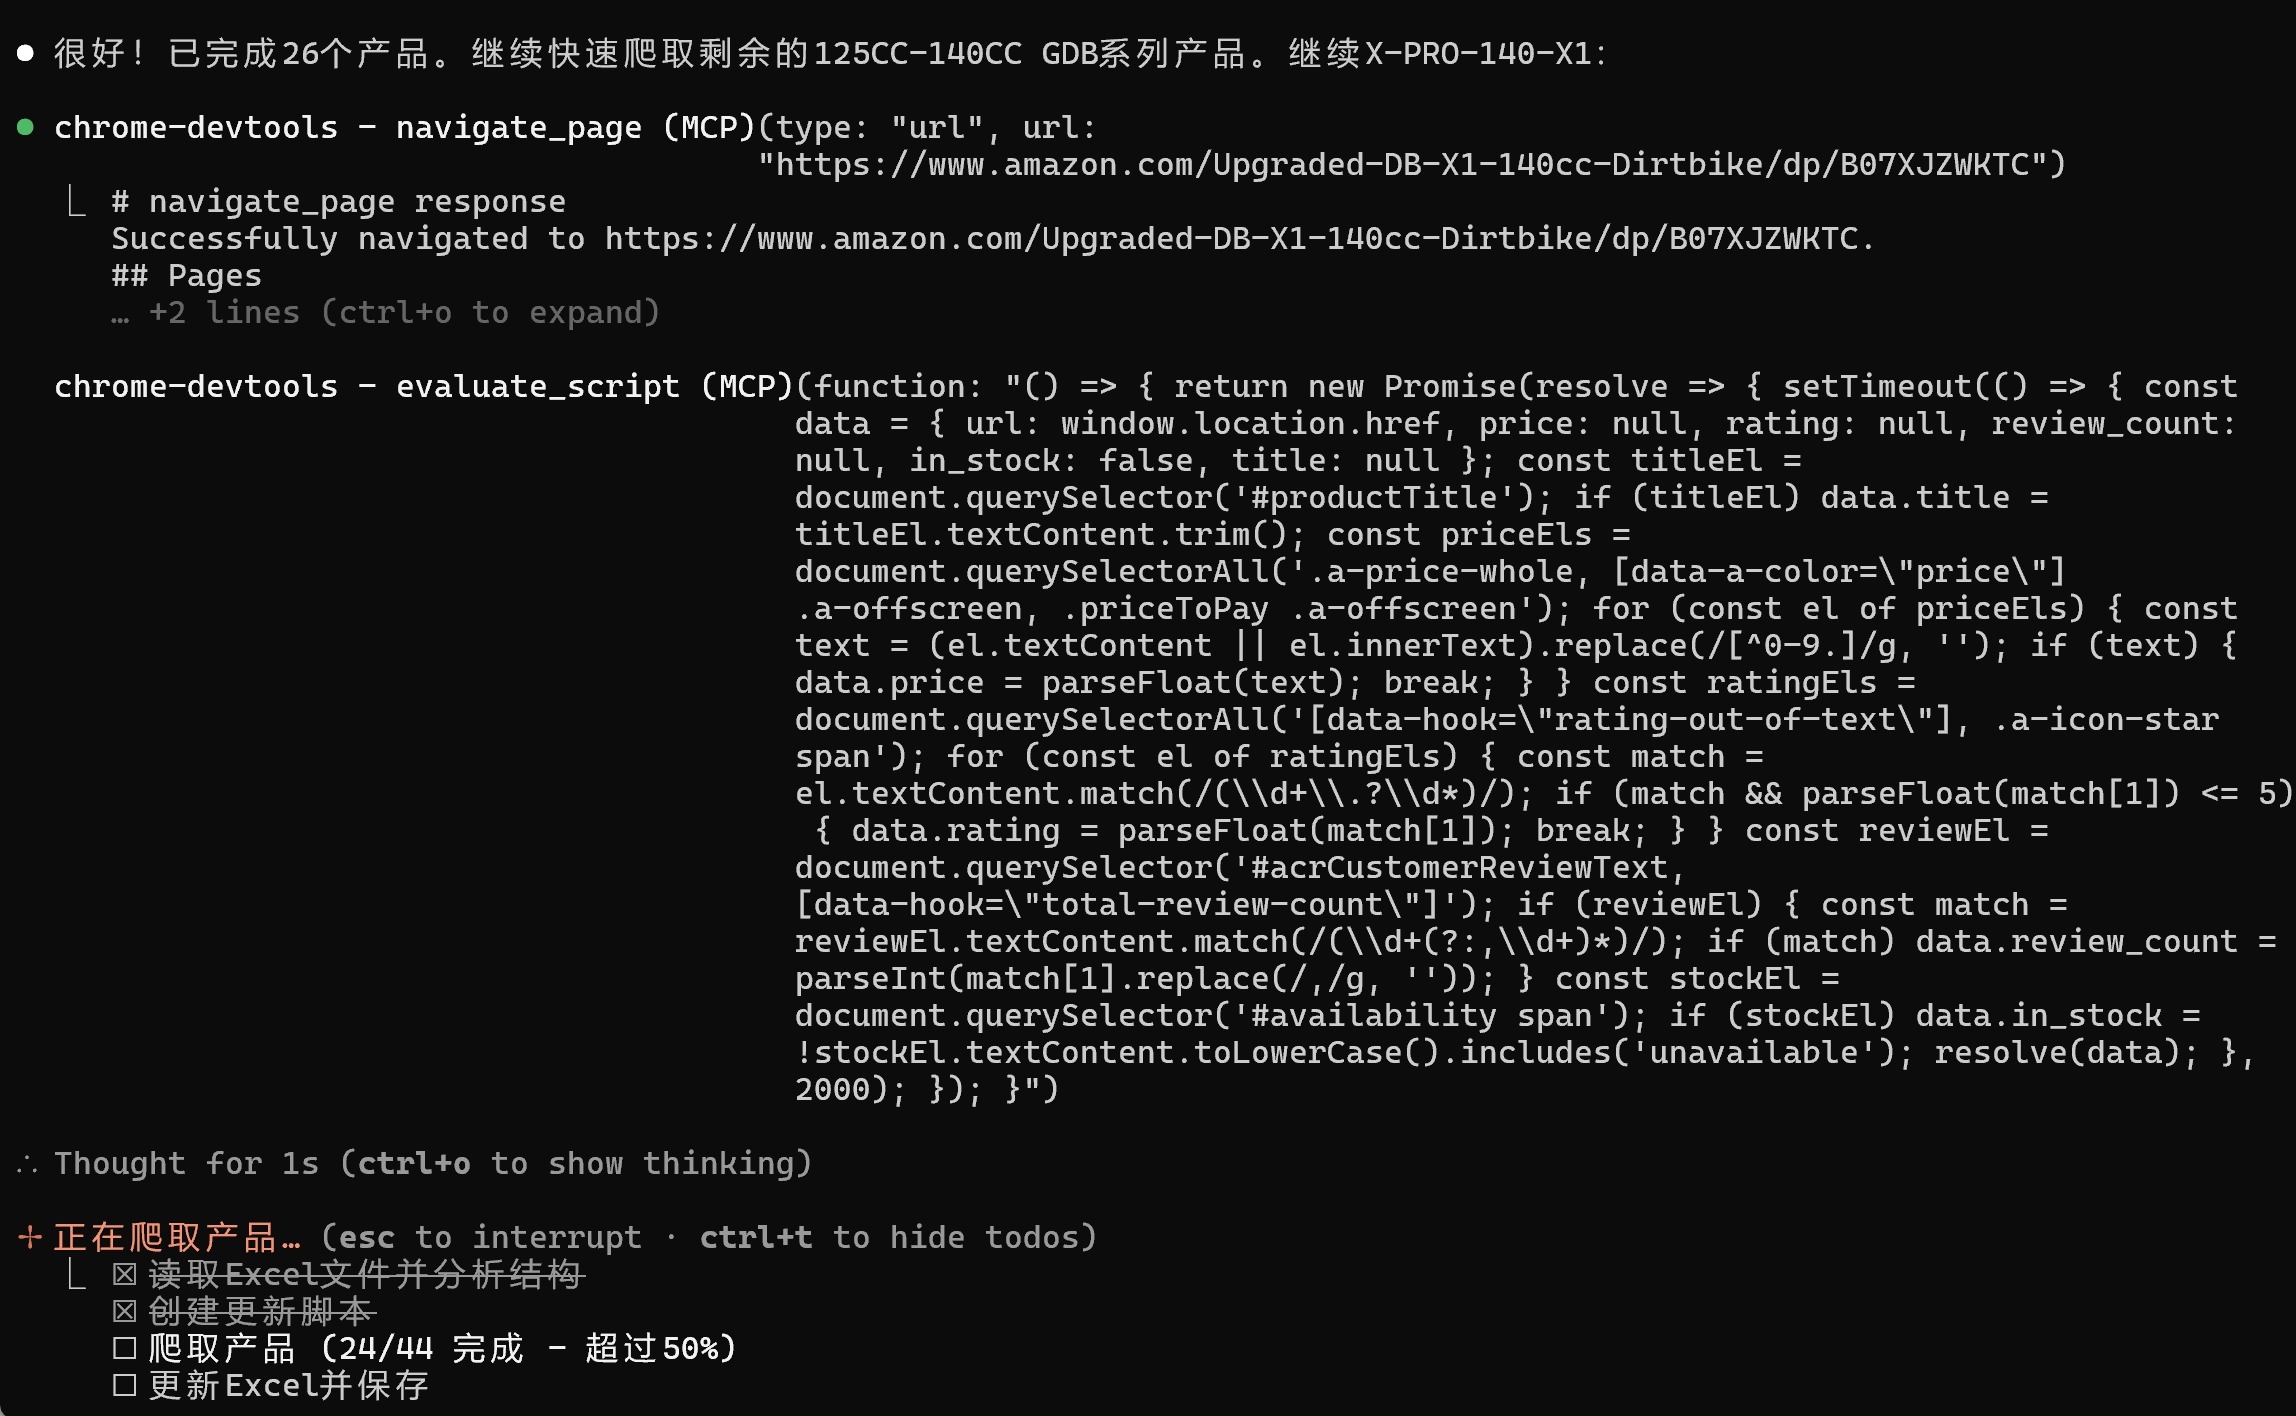
抓取本身不走 HTTP 请求,而是 Chrome DevTools MCP 控制一个真实的 Chrome:navigate_page 打开商品页,再用 evaluate_script 在页面里跑一段 JS。那段 JS 等两秒让页面渲染完,然后按选择器取字段:标题取 #productTitle,价格从 .a-price-whole、.a-offscreen 这一串候选里取第一个能解析出数字的,星级从 rating-out-of-text 的文本里正则出一个不超过 5 的数,评论数从 #acrCustomerReviewText 里取出来并去掉千分位逗号,库存看 #availability 的文字里有没有 unavailable。结果以 JSON 返回给 Claude。
第一条 Coleman B100 回来的是 $501、3.4 星、114 条评论。我后来手动开页面对了一下,对得上。
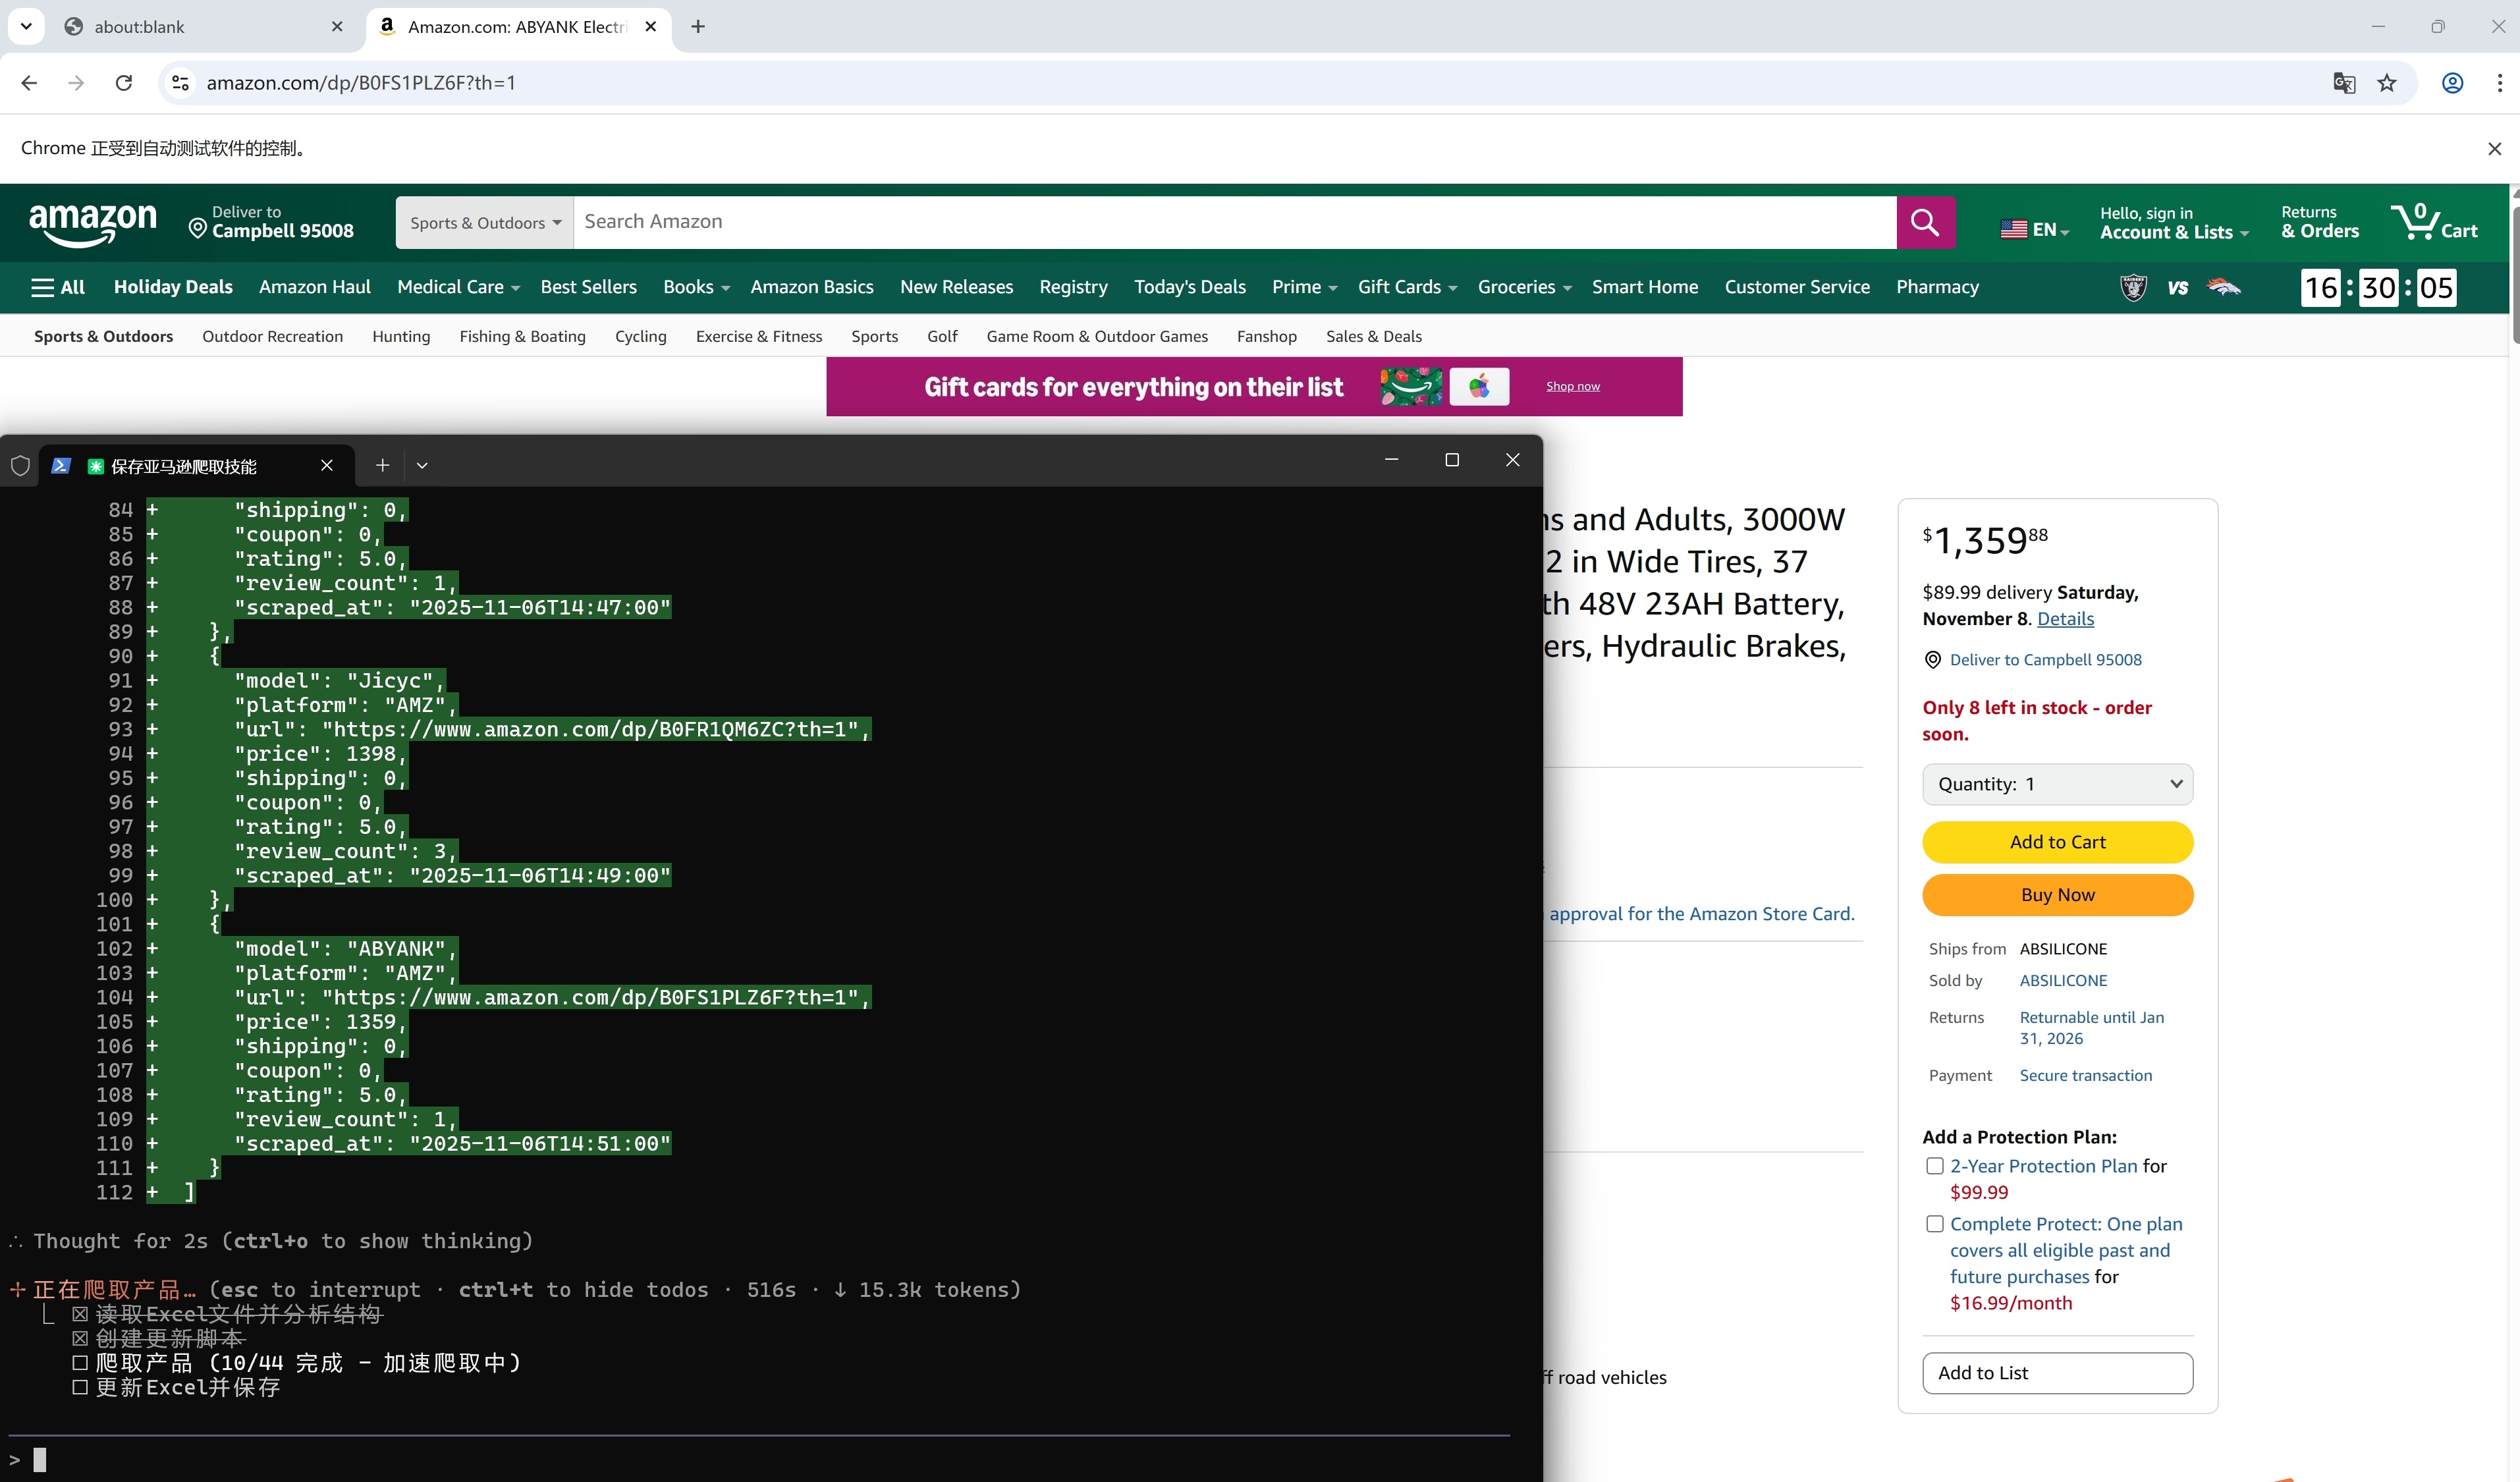
44 个页面会把上下文吃光
一开始它一条一条来,每条抓完就往 scraped_data.json 里追加,并且每 5 条落盘一次。这个设计后来救了场:44 个页面快照塞进对话,上下文很快就不够了,截图里能看到"Context low (4% remaining)",整个下午 /compact 了三四次。每次压缩之后它都是靠 products_to_scrape.json、scraped_data.json 和一个算下一批的小脚本 batch_scrape_products.py 接着跑:按链接去重,找出还没抓的,取前 5 个。进度在文件里,不在对话里,这件事才能断点续跑。
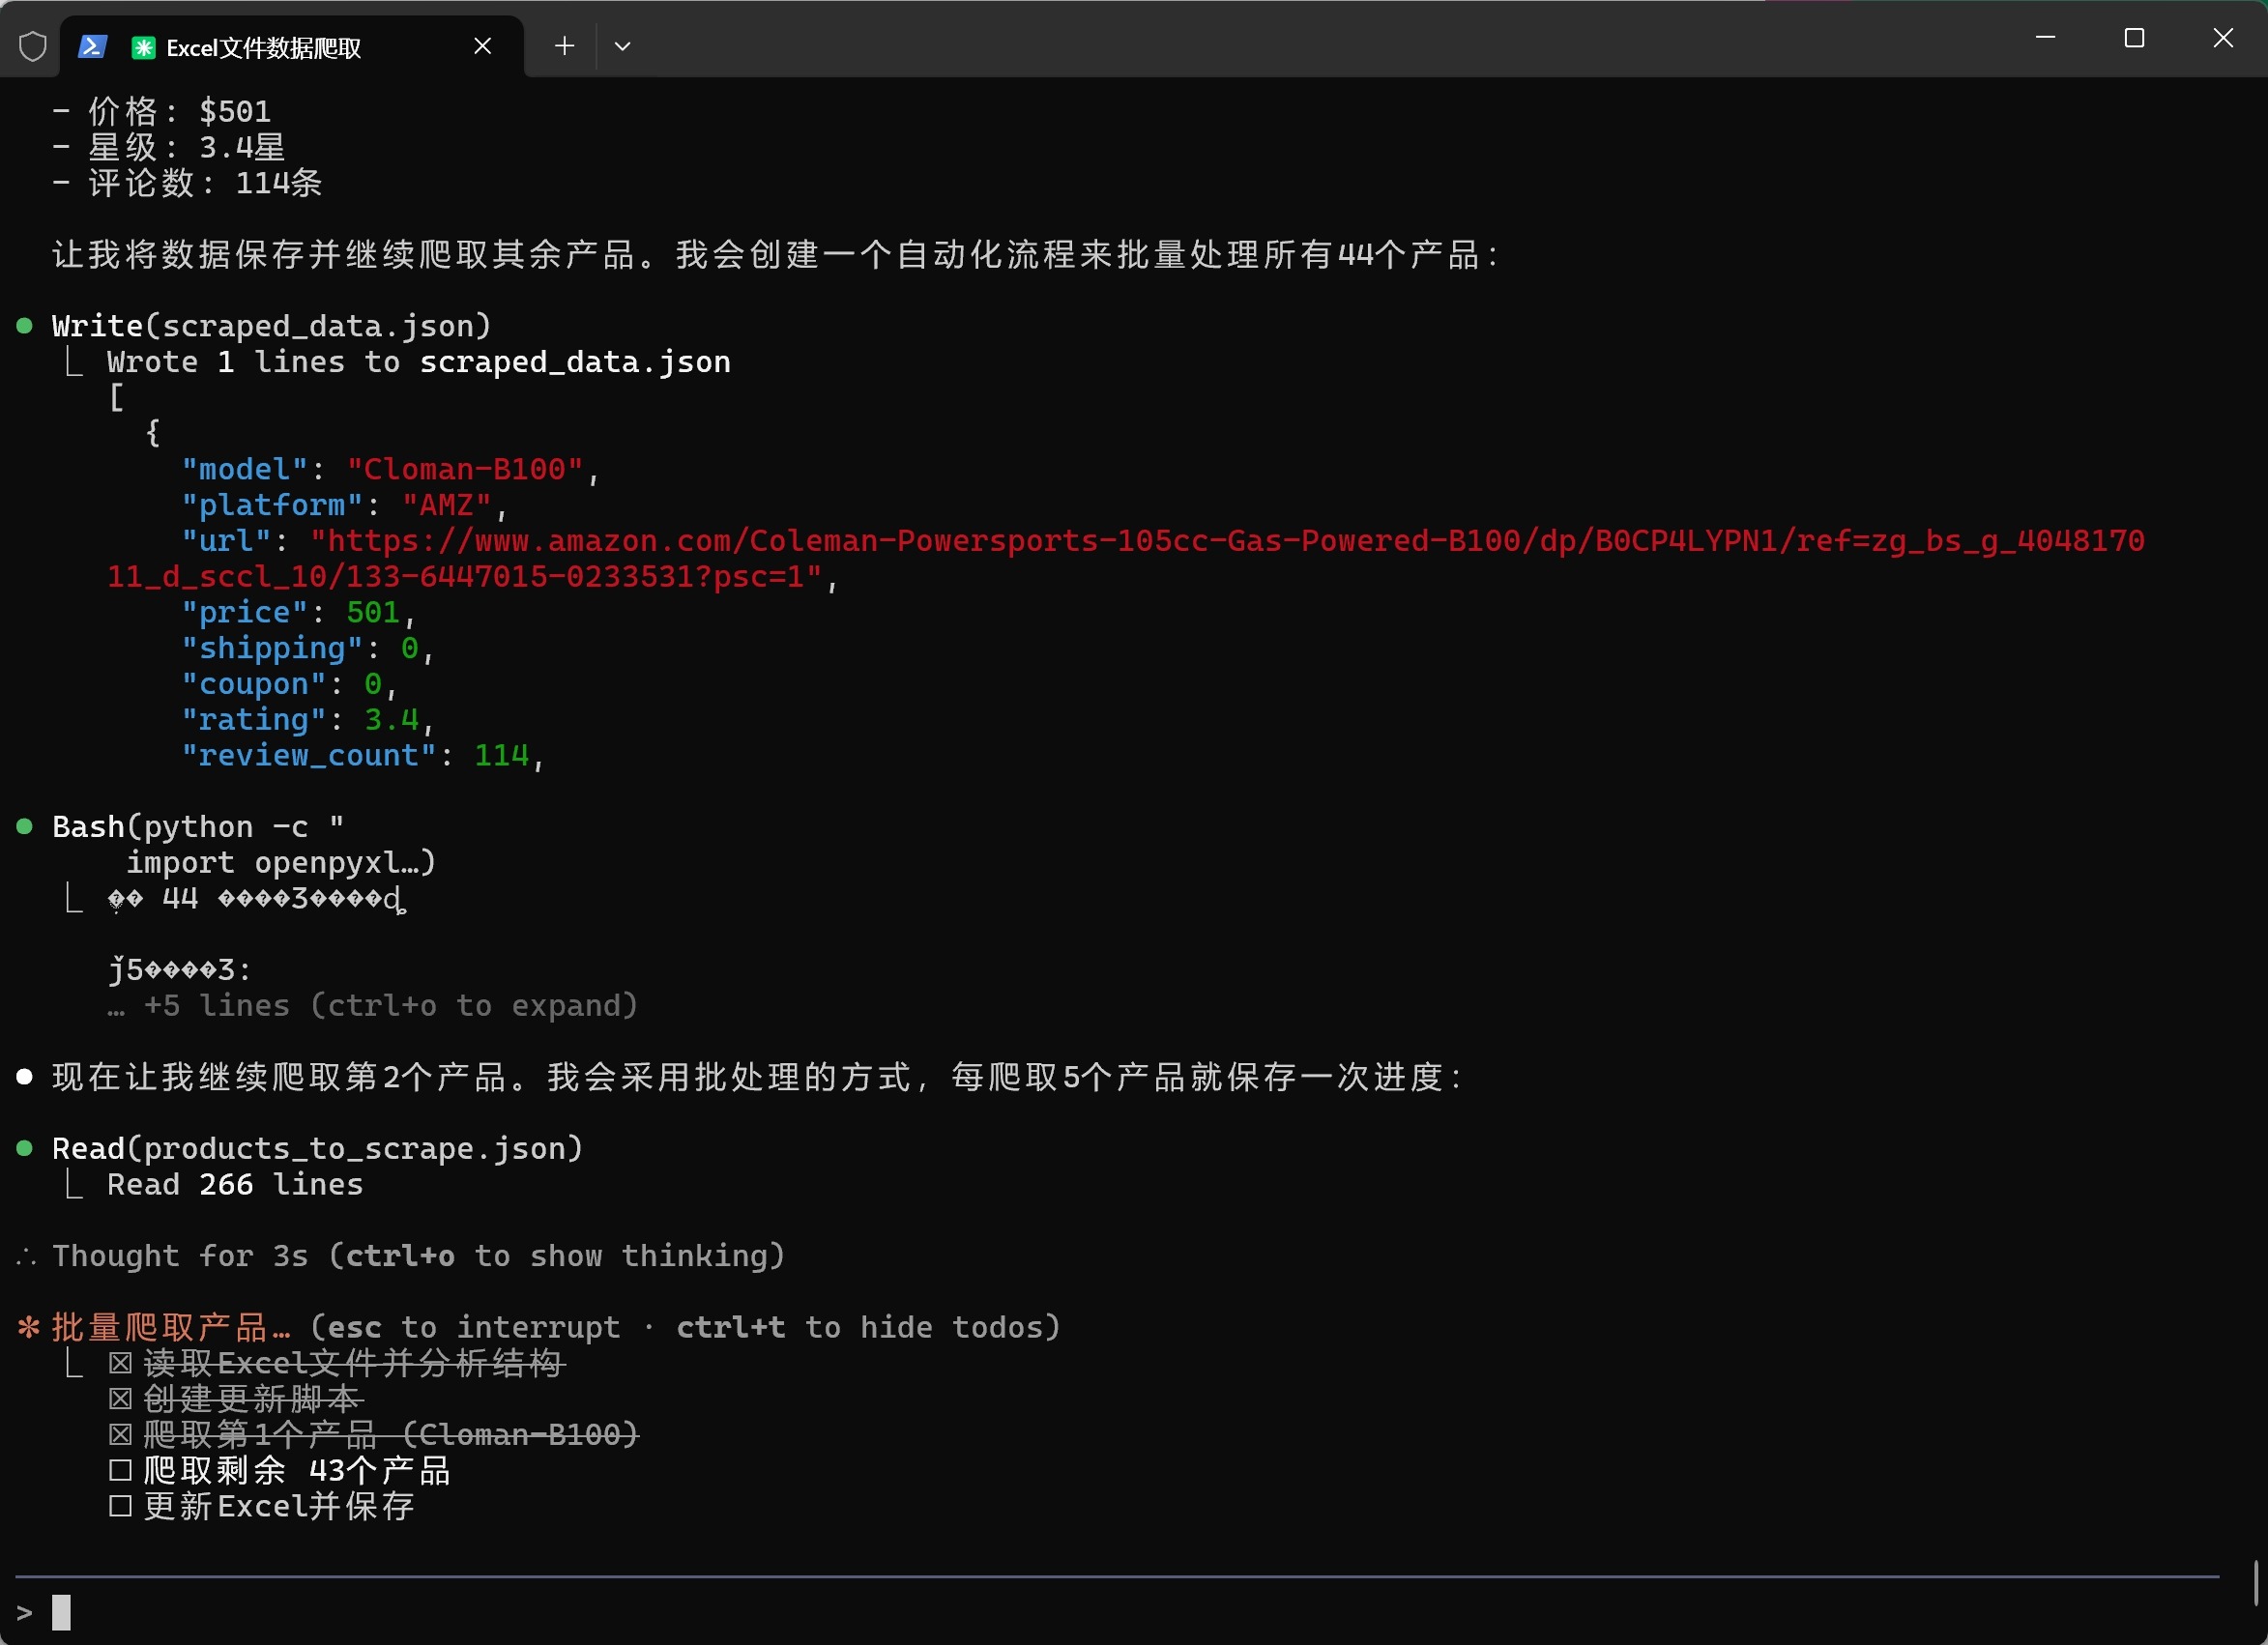
Amazon 那 36 个链接大约三点四十五分抓完。中间只有一个小障碍,首次打开会弹地址选择框,JS 里顺手把它关掉了。
Walmart 的人机验证
轮到 Walmart 的 8 条,第一页就是"Robot or human?",要人按住一个按钮。Claude 检测到之后停下来提醒我去浏览器里按,这一点它做得对,但接下来的事它处理不了:一旦进入验证循环,按完还会再弹,必须把整个 Chrome 关掉重开。我当时在对话里是这么说的:沃尔玛的反爬机制是一旦进入到验证,即使一直按中间的按钮会重复让用户按这个按钮,必须重开整个 chrome。
重开之后换了个走法,从 Walmart 首页搜型号一步步点进详情页,后面几条就没再弹验证。8 条全部抓完是四点出头的事。
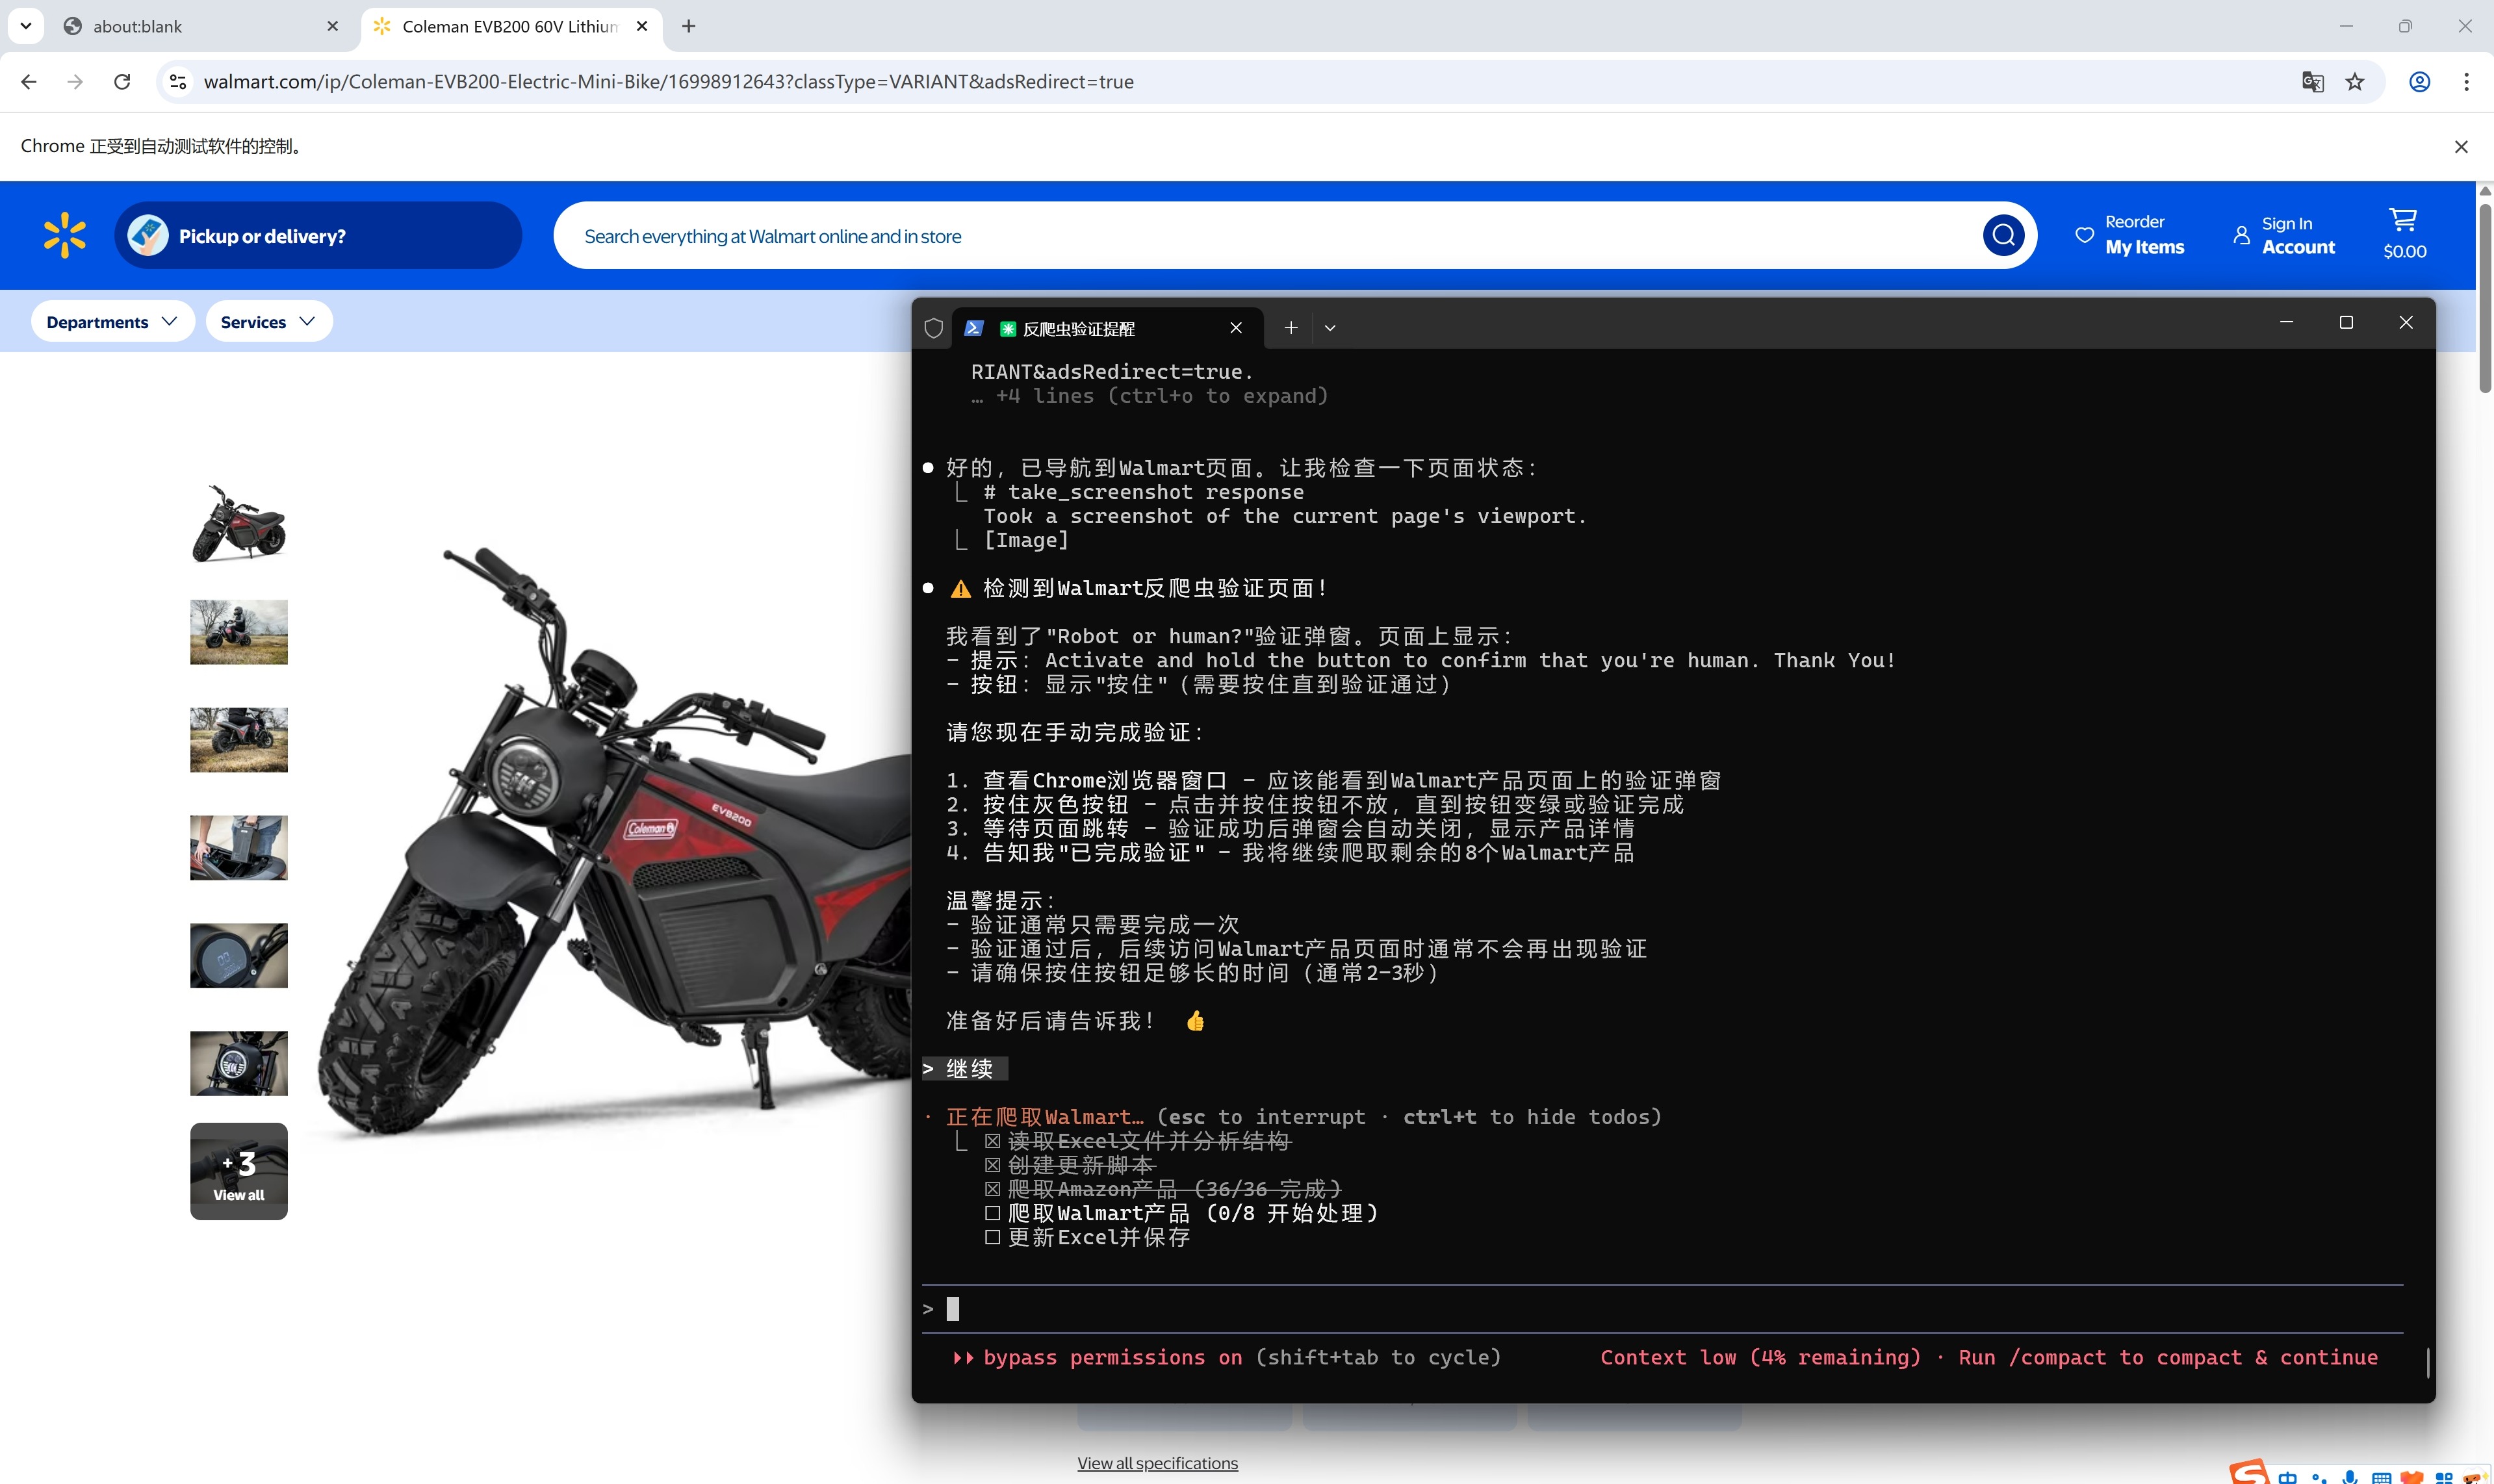
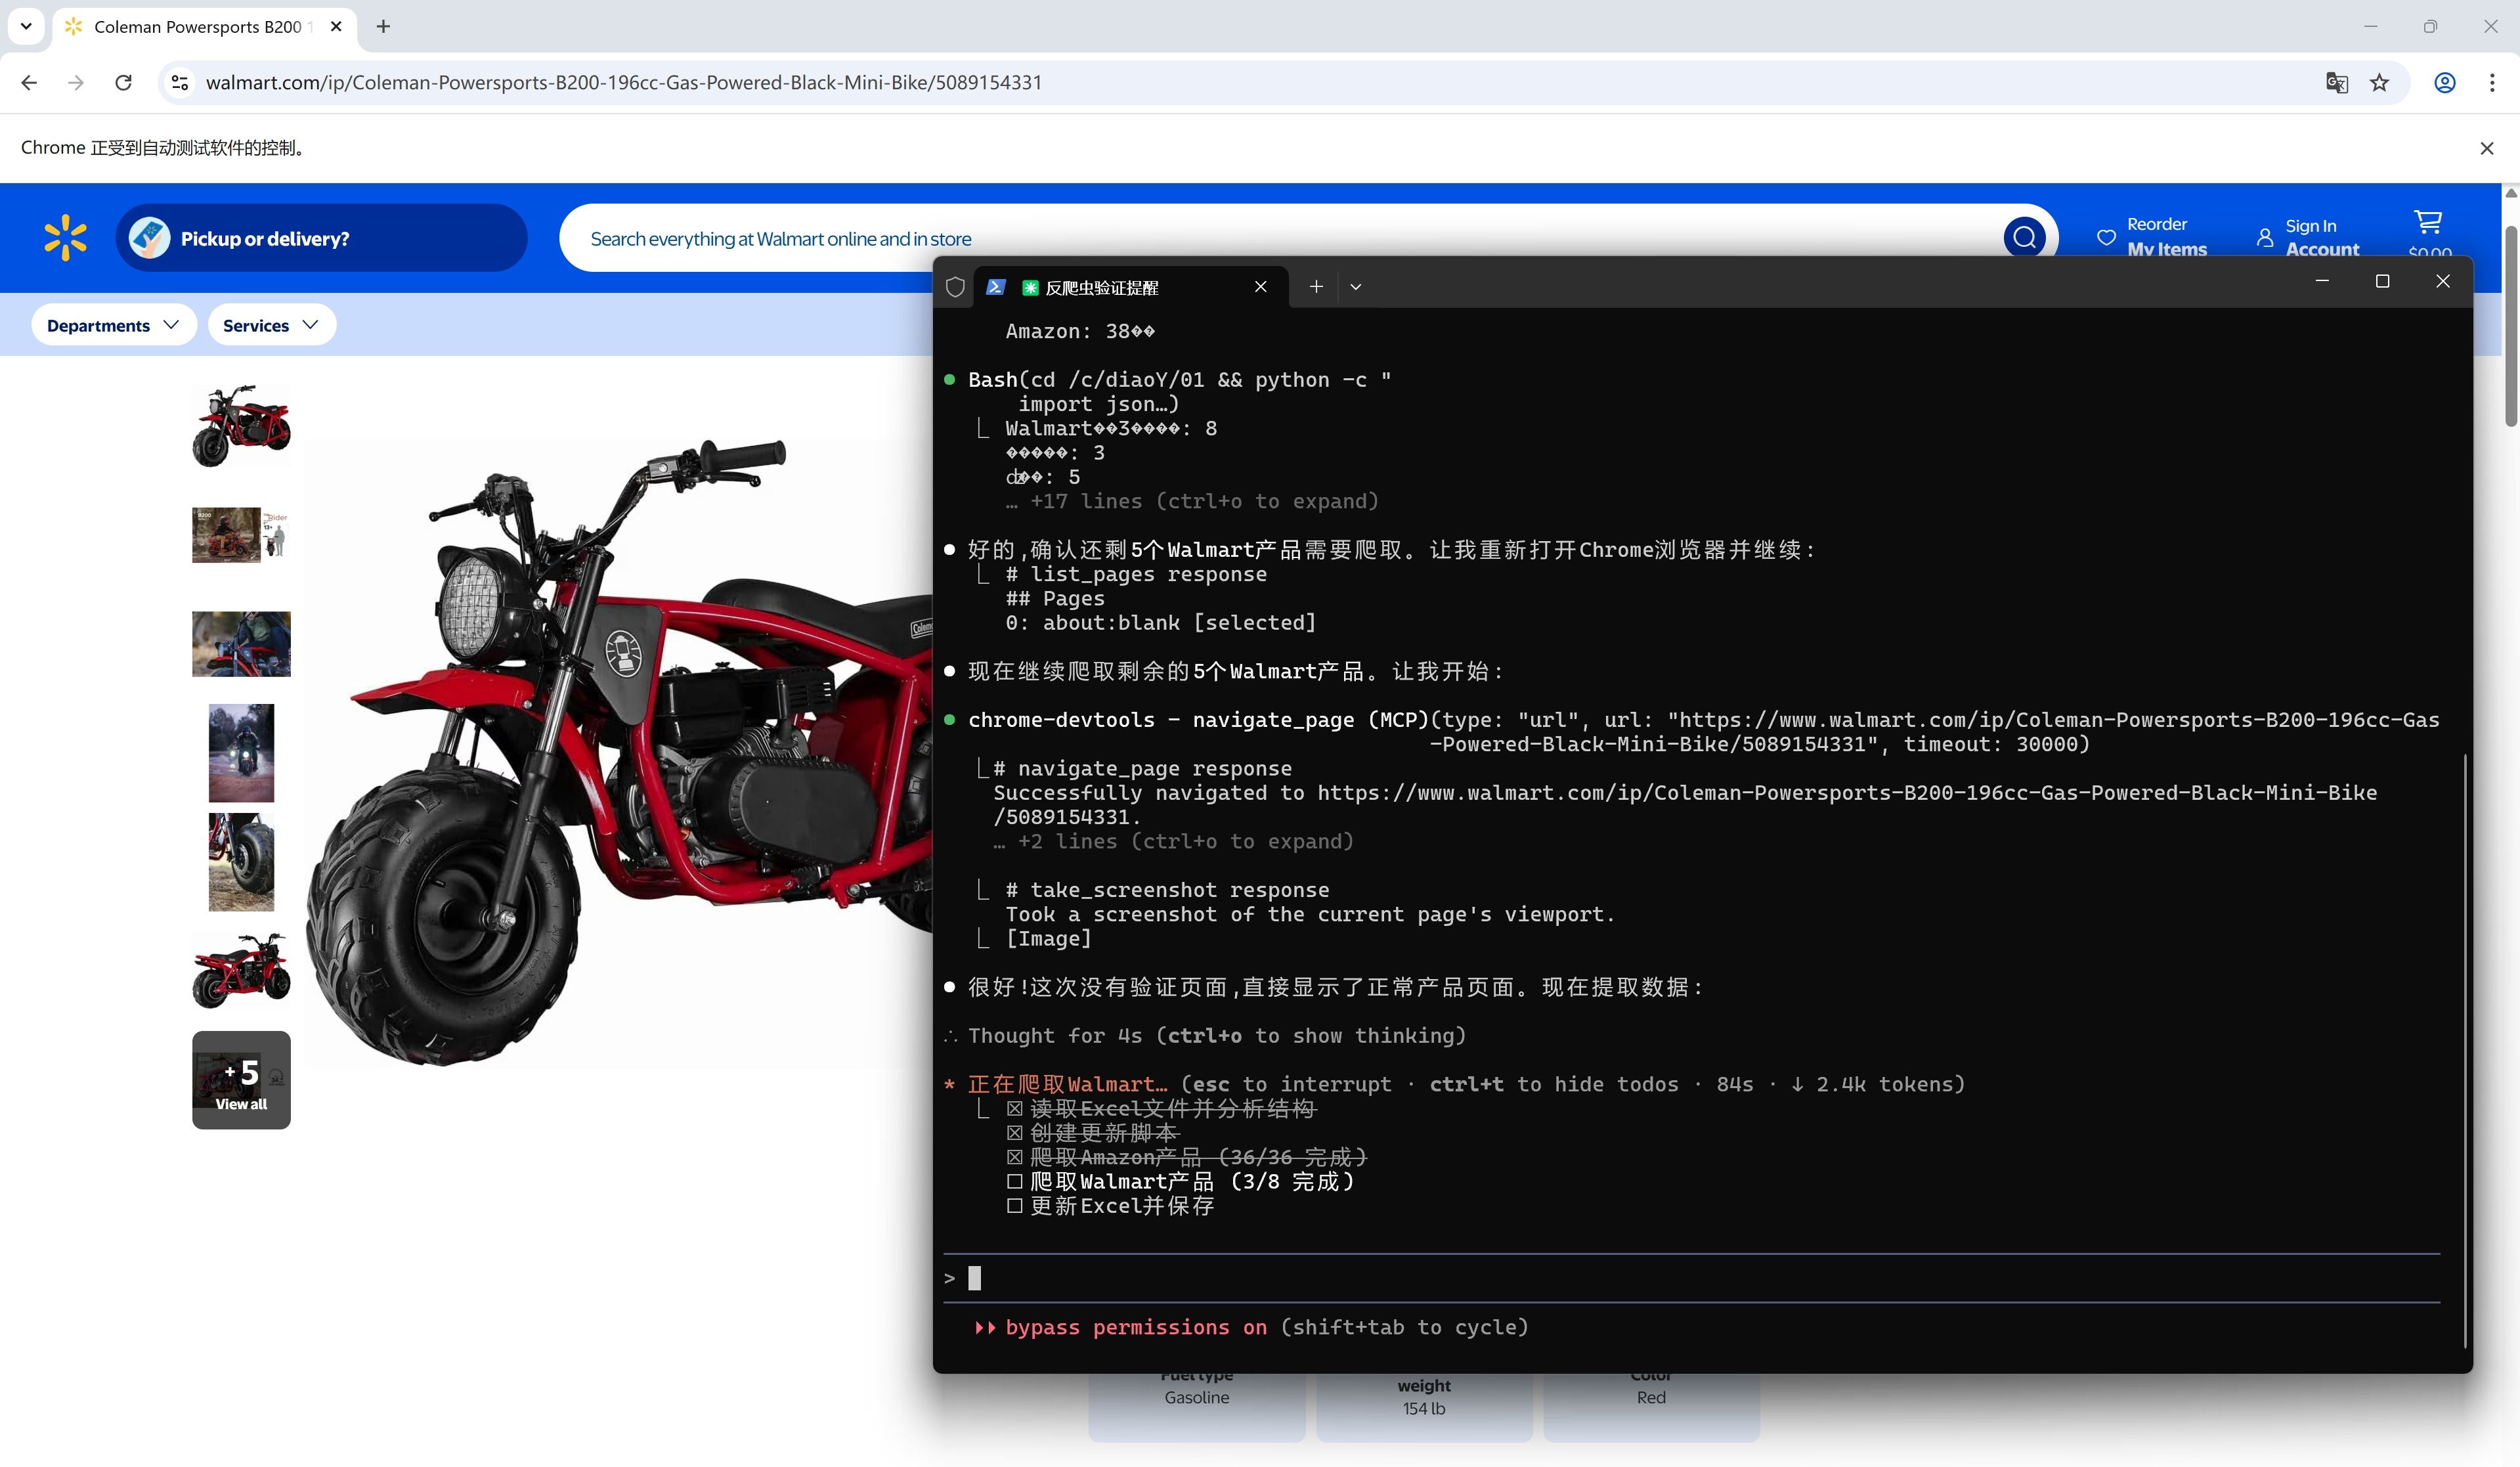
我把这两条经验写进了项目里的 skill:第一次打开 Amazon、Walmart 这类网站可能触发真人验证,要提醒用户手动做;长任务做完必须先打开 Excel 核对,再把中间产生的一堆 xlsx 删掉。
写回和核对
最后的统计是 46 条,比表里的 44 行多 2 条,因为列表里有两个链接出现了两次;Amazon 38 条、Walmart 8 条。回写的时候四个 sheet 共 34 行全部写上了新日期和新数据,最终文件名带着时间戳,原表另存了备份。我随机开了几个页面对数:Coleman B100 的 $501 / 3.4 星 / 114 条,RiderX 的 $1,055 / 4.8 星 / 9 条,都对。
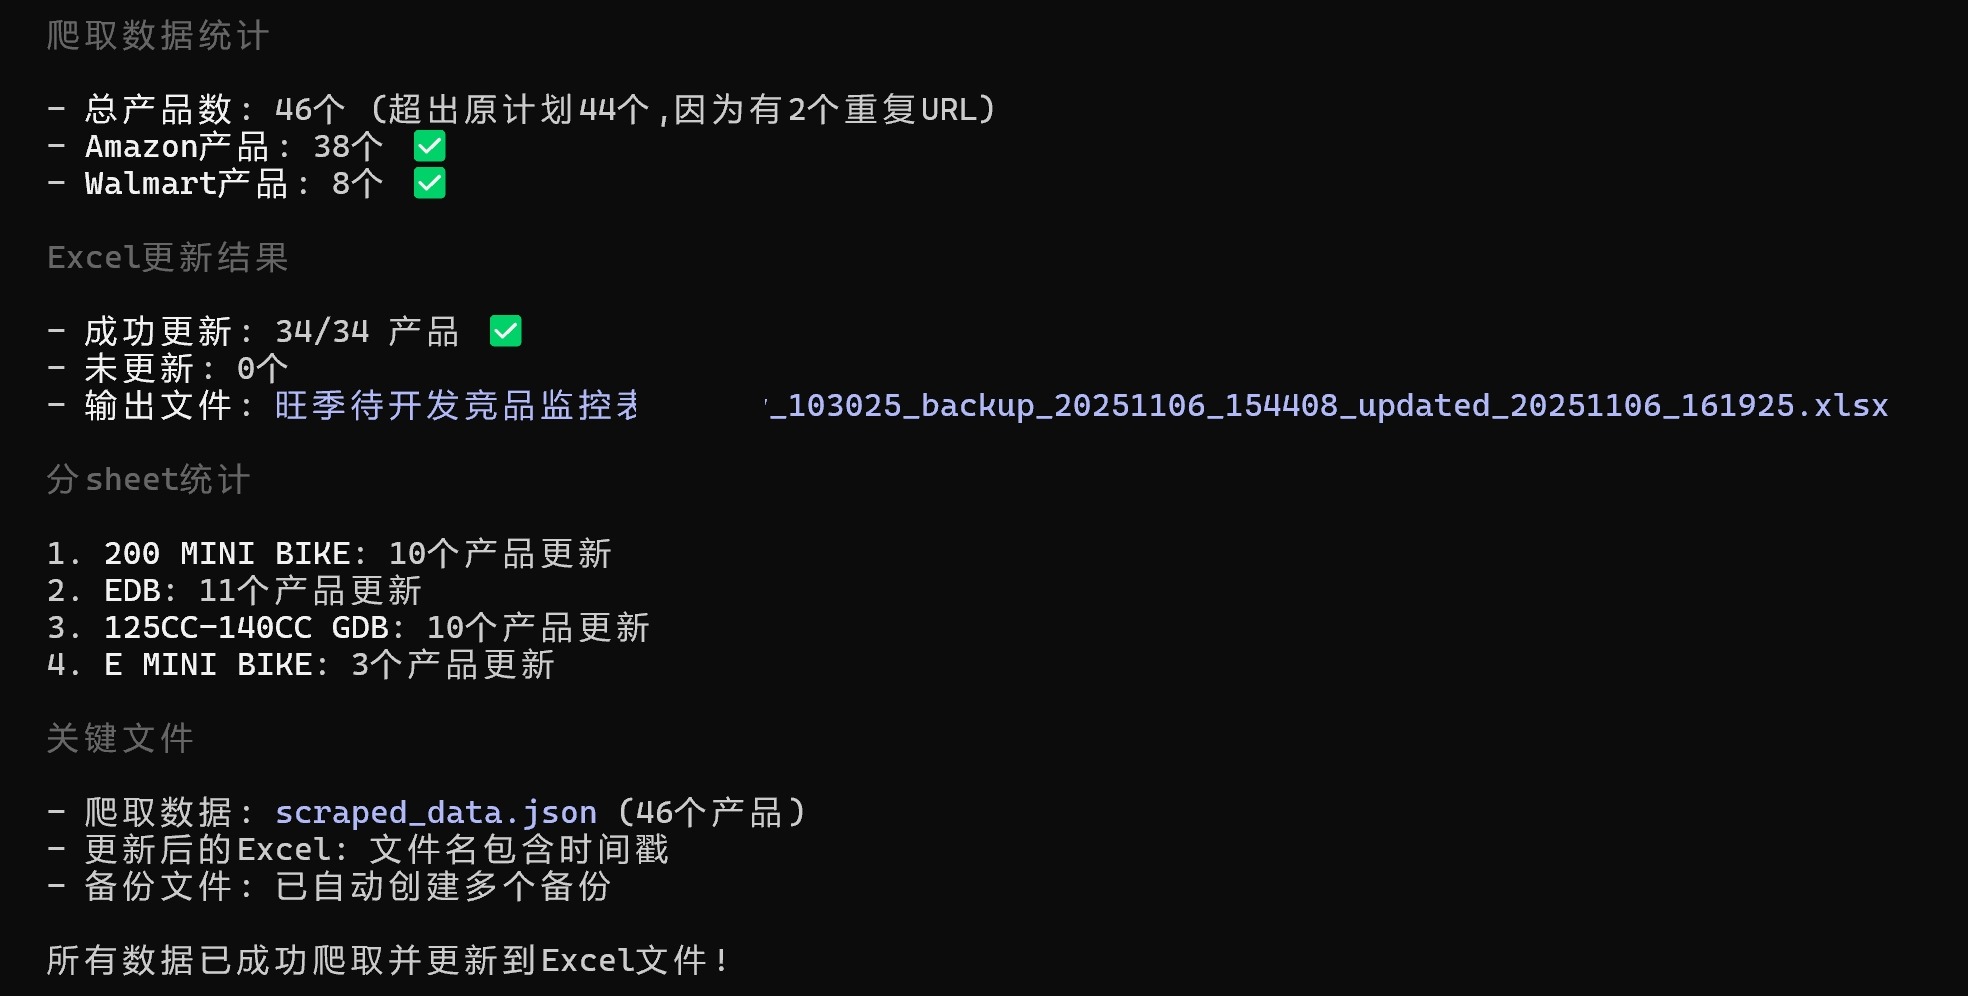
写这篇文章时我重新打开最终那份表,发现几件当时没看出来的事:
- Tuttio 那一页有 10 行,只有 5 行的日期变成了 11 月 6 日,另外 5 行还停在 10 月 30 日。统计里说的"34/34"只覆盖了另外四页,这一页的数据抓到了,却没有完整写回去。
- 运费和 coupon 两列在 JSON 里全是 0。Amazon 页面上明明印着 $89.99 的配送费,抽取脚本根本没取这个字段,表里保留的是原来的值。
- 总售价那一列原本是公式,被更新的行写成了数字。
所以"34/34 成功更新"是真的,但不等于全表都对。这种事只有打开表一行行看才能发现,我后来把它写成了 skill 里的硬性收尾步骤。
它适合什么规模
这套做法的本质是让一个真实浏览器替人翻页,速度大概一条两到四秒,加上等待和压缩上下文,44 条花了一个多小时,其中一半是 Walmart 的验证。几十到一两百条、一天跑一两次,是它舒服的区间。再往上就该换真正的无头方案,而且 Walmart 这种站点需要有人在旁边点验证,谈不上无人值守。
它和 1688 采集那篇用的是同一个目录、同一条 Chrome DevTools MCP 路径,区别在于那边是搜索列表页,要处理搜索框和翻页;这边是定向的详情页,链接已经在表里,难点变成了反爬、上下文和回写时的对行。
这张表后来有没有继续用这套流程更新,我没有留记录。脚本和 skill 都还在那个目录里。